
作者:
李强强 小红书OLAP引擎研发工程师
俞钊 小红书OLAP引擎研发工程师
在准备训练数据时,模型团队通常需要做两类查询。一类是用 SQL 预览样本、按字段筛选和排序,并统计数据特征。另一类是通过向量相似性检索找到候选样本,再查看样本内容。两类查询都需要处理包含长文本、对话数组和图片等内容的数据集,而这些数据集的规模也在持续增长。
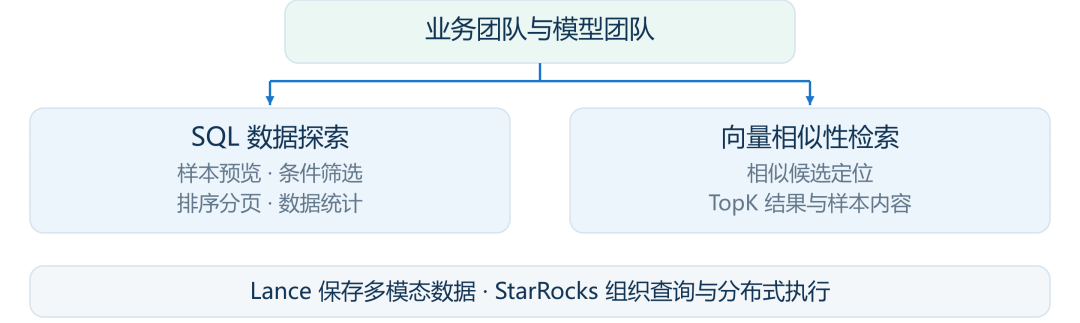
图 1 · 面向业务与模型团队的两类检索需求
Lance 是一种支持高效随机读取的数据湖格式,适合在筛选或检索后按需读取样本内容。随着越来越多的训练数据集采用 Lance 格式存储,小红书 OLAP 引擎团队与社区合作,将 StarRocks 的 SQL 规划、分布式执行和缓存能力接入 Lance 读取链路,以支持模型团队在这些数据集上进行 SQL 探索和向量检索。
本文以小红书内部的数据集探索和向量检索为例,介绍 StarRocks 查询 Lance 数据集时遇到的性能瓶颈、对应的优化方法及实测效果。
01 优化实践:StarRocks 对 Lance 的查询与向量检索优化
在这两类场景中,性能瓶颈主要出现在数据读取和任务调度两个环节。读取侧的开销来自宽列的提前读取、元数据的重复加载与解析,以及缓存复用不足。调度侧则容易因扫描任务或索引检索任务分配不均而出现长尾。围绕这些问题,小红书 OLAP 引擎团队与湖团队及社区合作,从 TopN 延迟物化、扫描任务划分、读取链路和索引段调度四个方面进行了优化。
TopN 延迟物化:减少宽列的无效读取
在数据集探索场景中,一条只返回一页结果的 ORDER BY ... LIMIT 查询,冷查耗时仍达到 7.5~11 秒。Query Profile 显示,扫描阶段读取的数据量远超最终结果集。长文本、图片等宽列仅用于展示,扫描候选记录时却已经为这些列付出了 I/O 和解码开销。为此,StarRocks 将读取分为两个阶段:先读取过滤列、排序列和 RowId,完成全局 TopN,再根据入选记录的 RowId 回读结果所需的其余列。两个阶段读取同一版本的数据集,确保回读的样本内容与筛选、排序时使用的数据一致。
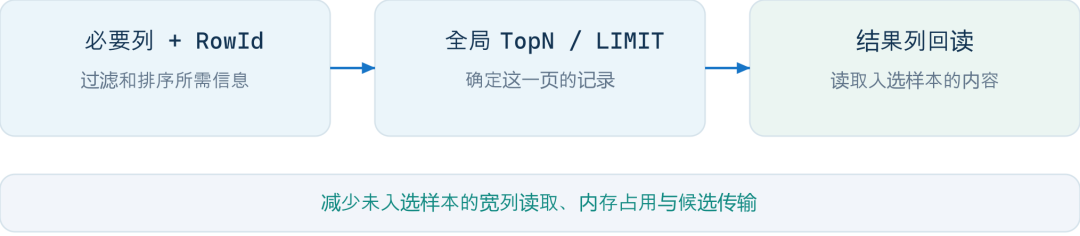
图 2 · TopN 延迟物化的两阶段读取
Scan Range 切分与合并:提升扫描并行度
不同 Lance 数据集中的 Fragment(数据片段)大小和数量差异较大。当数据集中在少数大 Fragment 中时,扫描工作容易集中在少数任务上。其他任务即使已经完成,查询仍要等待这些任务结束,从而出现长尾。
为此,Lance SDK 增加了 Scan Range 规划和按范围读取能力。StarRocks 根据数据量、行数和可用并行度确定扫描任务的粒度。对于大 Fragment,StarRocks 调用 SDK 按行范围切分,将不同范围交给多个任务并行扫描。对于小 Fragment,则将多个片段合并到同一个扫描任务中,减少任务调度和初始化开销。
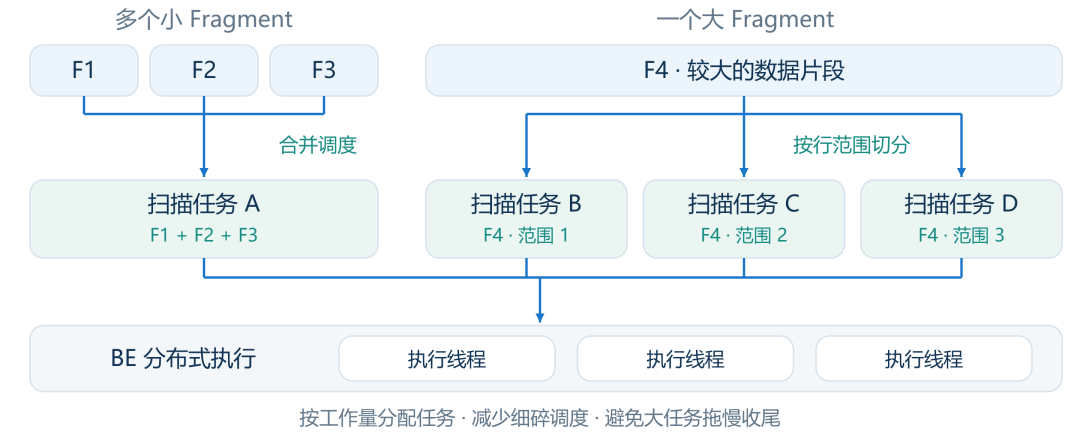
图 3 · 大 Fragment 按行范围切分,小 Fragment 合并调度
读取链路优化:减少重复初始化与远程读取
冷读时,扫描和索引检索任务需要先加载相关元数据。多个任务同时启动时,可能重复读取和解析同一份元数据。对于 Fragment 较多的数据集,加载 Fragment 元数据也会拉长任务启动时间。
Lance 读取链路针对三个环节做了优化。在同一 Session 内,对同一数据集版本的 Manifest 合并并发加载请求,共享读取和解析结果。对于采用 RED 扩展元数据布局的数据集,支持对 Fragment 元数据分组、分页和按范围读取,并控制并发读取,减少等待和重复读取文件头的开销。在索引初始化阶段,同样合并并发加载请求,只读取相关索引的附属元数据,并复用打开索引时已解析的文件元数据。
在 StarRocks 侧,扫描任务可复用固定版本的 Dataset 对象及其元数据,减少重复初始化。对于 Java Reader 的常规扫描,开启扫描输出缓存后,如果数据版本、扫描参数和输出列配置均相同,Data Cache 可以复用已缓存的数据批次,减少重复读取和解码。
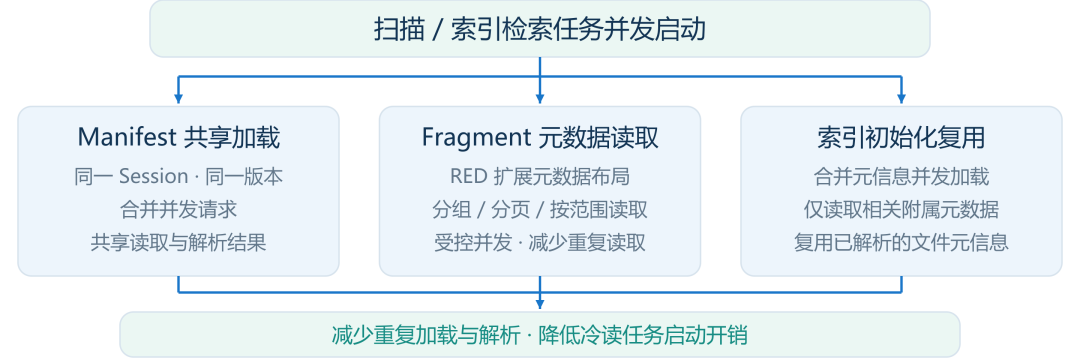
图 4 · Manifest、Fragment 与索引元数据的加载优化
向量检索:兼顾负载均衡与缓存复用
在模型训练数据集的向量检索中,索引缓存命中率直接影响查询耗时。复用已加载的索引可以减少远程读取和初始化开销。查询还需要等待最慢的节点完成检索,因此,即使多数节点已返回候选结果,个别节点上的任务积压仍可能拉长整体响应时间。
最初的哈希调度让同一索引段尽量分配到同一节点,以便复用缓存。当多个索引段集中到同一节点时,该节点就可能成为瓶颈。为此,StarRocks 为每个节点设置索引段数量配额,在配额内尽量保留原有的哈希分配,将超出配额的任务分配给仍有余量的节点,并参考各索引段覆盖的行数进一步平衡工作量。
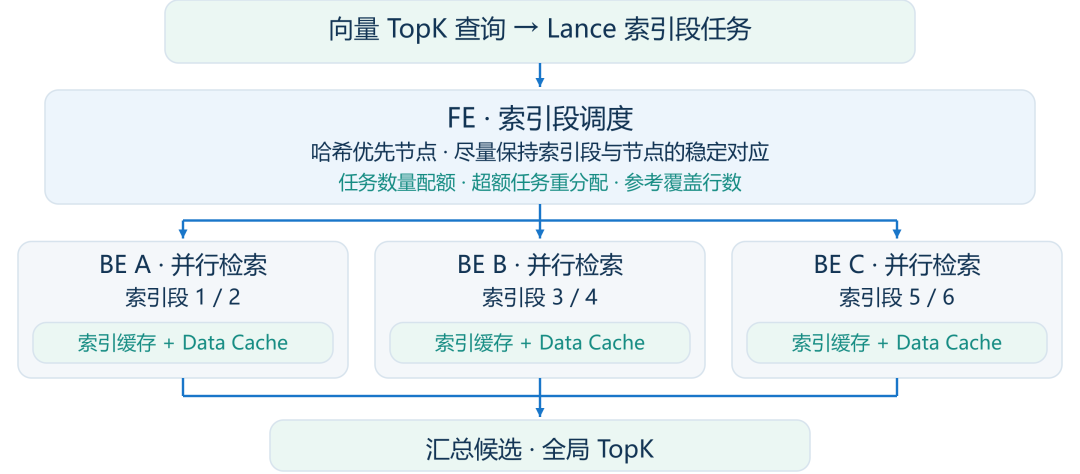
图 5 · 兼顾负载均衡与缓存复用的索引段调度
执行时,各 BE 并行检索分配到的索引段,执行层汇总各节点返回的候选结果,得到全局 TopK。每个 BE 复用 Lance SDK Session 和热点索引缓存,并合并针对同一缓存项的并发加载请求。读取索引文件时,StarRocks 通过 Data Cache 减少对 OSS 的重复访问。
02 业务收益:数据集探索与向量检索的性能提升
数据集探索:4 项统计查询耗时下降 82.0%~90.9%
小红书 OLAP 引擎团队从实际业务中选取了 4 项耗时最高的高频统计查询,覆盖混合对话、长文本问答、指令数据集和数学对话。优化后,4 项查询的冷读耗时均降至 2.4 秒以内,其中 3 项低于 1 秒。
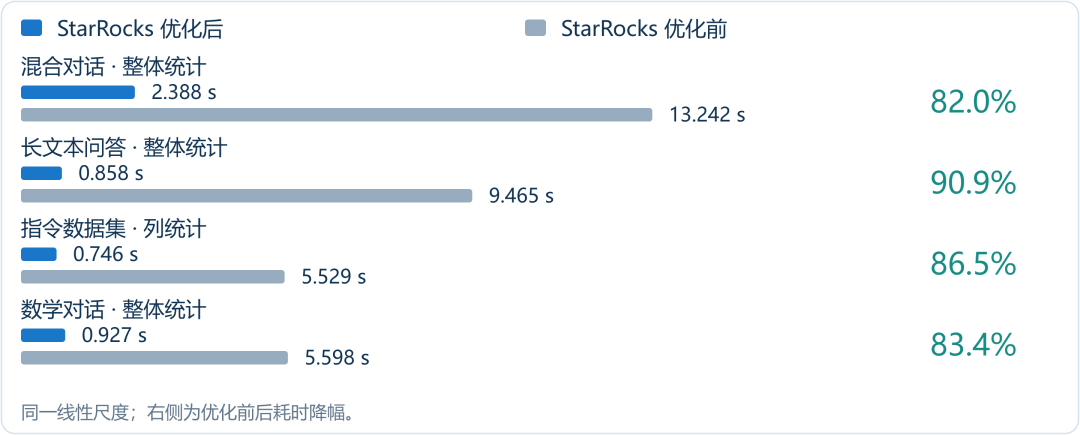
图 6 · 4 项代表性统计查询的冷读耗时对比
向量检索:冷查与热查的平均响应时间均缩短
向量检索测试使用小红书内部的模型训练数据集,共 70 亿行、2 TB。测试采用 1024 维向量,以近似余弦距离进行 Top 100 召回,并发数为 10。在这一测试条件下,冷查的平均响应时间从 15 秒降至 5.9 秒,下降约 61%。热查从 4.5 秒降至 1.494 秒,下降约 67%。
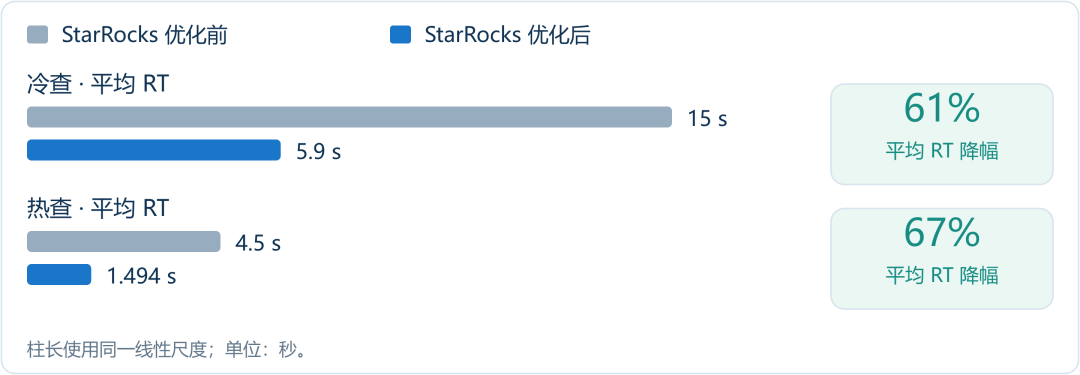
图 7 · 向量检索优化前后的冷查与热查平均响应时间
03 后续演进:面向百亿级向量检索
目前,小红书已在生产环境中使用 StarRocks 和 Lance,为内部模型团队提供低延迟的数据集探索与多模态检索服务,支持样本预览、筛选、统计分析和向量检索。
面向百亿级向量检索,小红书 OLAP 引擎团队计划在更大规模的索引上验证分布式执行、缓存效率和并发能力,并结合召回率、响应时间和资源成本评估方案,支撑模型团队在更大的数据集中发现和筛选训练样本。
小红书 OLAP 引擎团队也期待与 StarRocks 和 Lance 社区继续合作,将生产环境中遇到的问题、优化方法和验证经验反馈给社区,为后续改进提供参考。